KDE: Kernel Density Estimation
KDE
Kernel Density Estimation(KDE),核密度估计。顾名思义,这就是一个用一个“核”来估计你观测到的离散值的概率密度估计方法。
引言
首先看这张图:
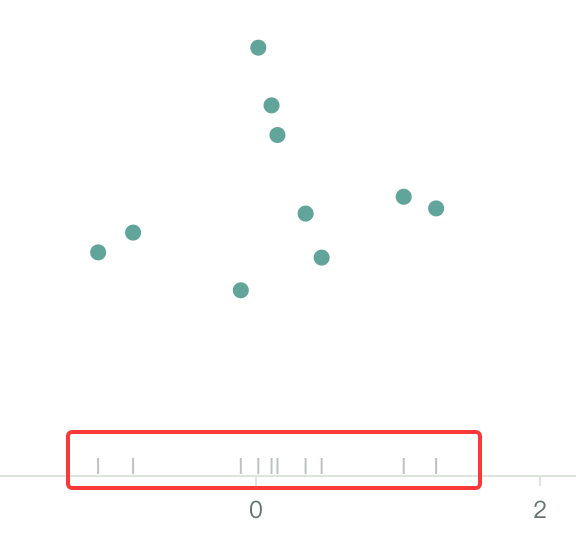
就是一个未知分布的散点图,横轴就是观测到的信息。我想要根据这些观测到的离散点来求出这个事件的大概分布和或概率密度。
那么最直观最简单的方式就是“矩形”框法,直接把横轴分成等分的小段,落在这个区间内的就计数,完全的统计方法:
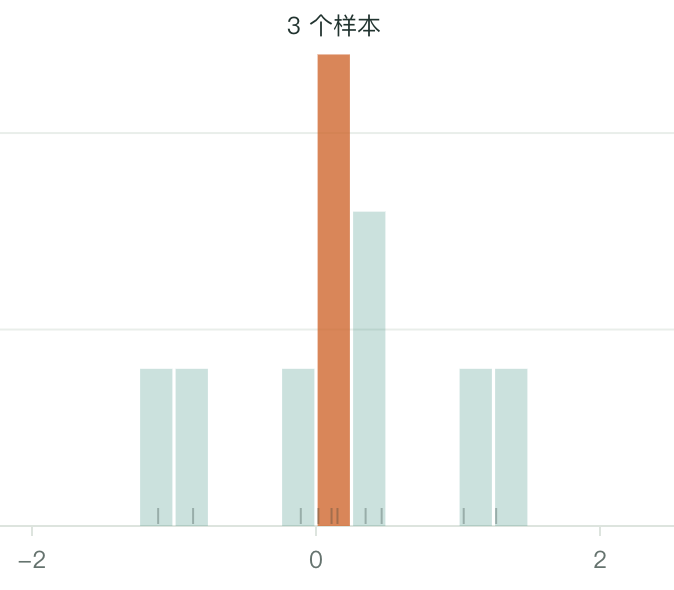
比如区间宽度为0.5,那么统计结果就是如上图所示。
引入KDE
为什么需要KDE
很明显,原来的矩形统计方法太“糙”了,存在一些问题:
- 没有细粒度的描述整个分布
- 标量统计结果,无法用于目标函数的优化
这个目标函数的优化 就是:我的目标函数需要用到我观测数据的分布,但是我又不知道这个观测数据的具体分布形式,只能用估计了。
举个例子:一个求期望的目标函数优化:
是概率,可以有概率密度分布求积分的到。
KDE
从上面就知道了,KDE可以:1.更细粒度的刻画分布 2.可以用于目标函数的优化(可以求导)。
它是怎么操作的呢?其实看起来很简单,就是给每一个观测点加一个帽子。
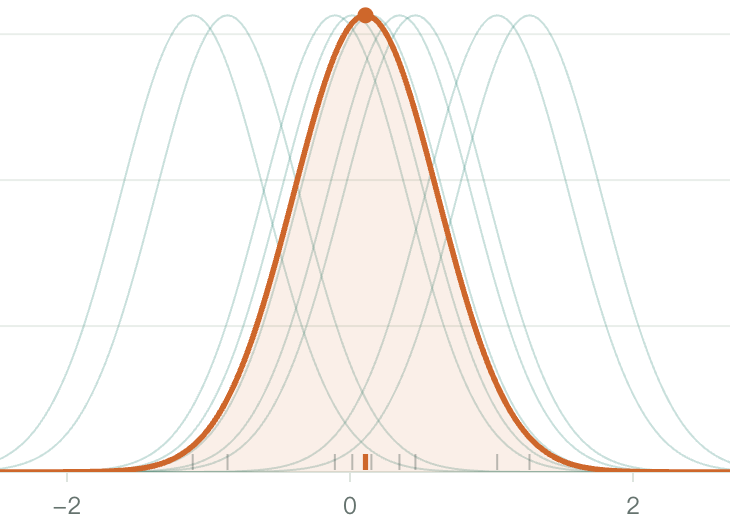
这个帽子就是核函数,以高斯核为例:
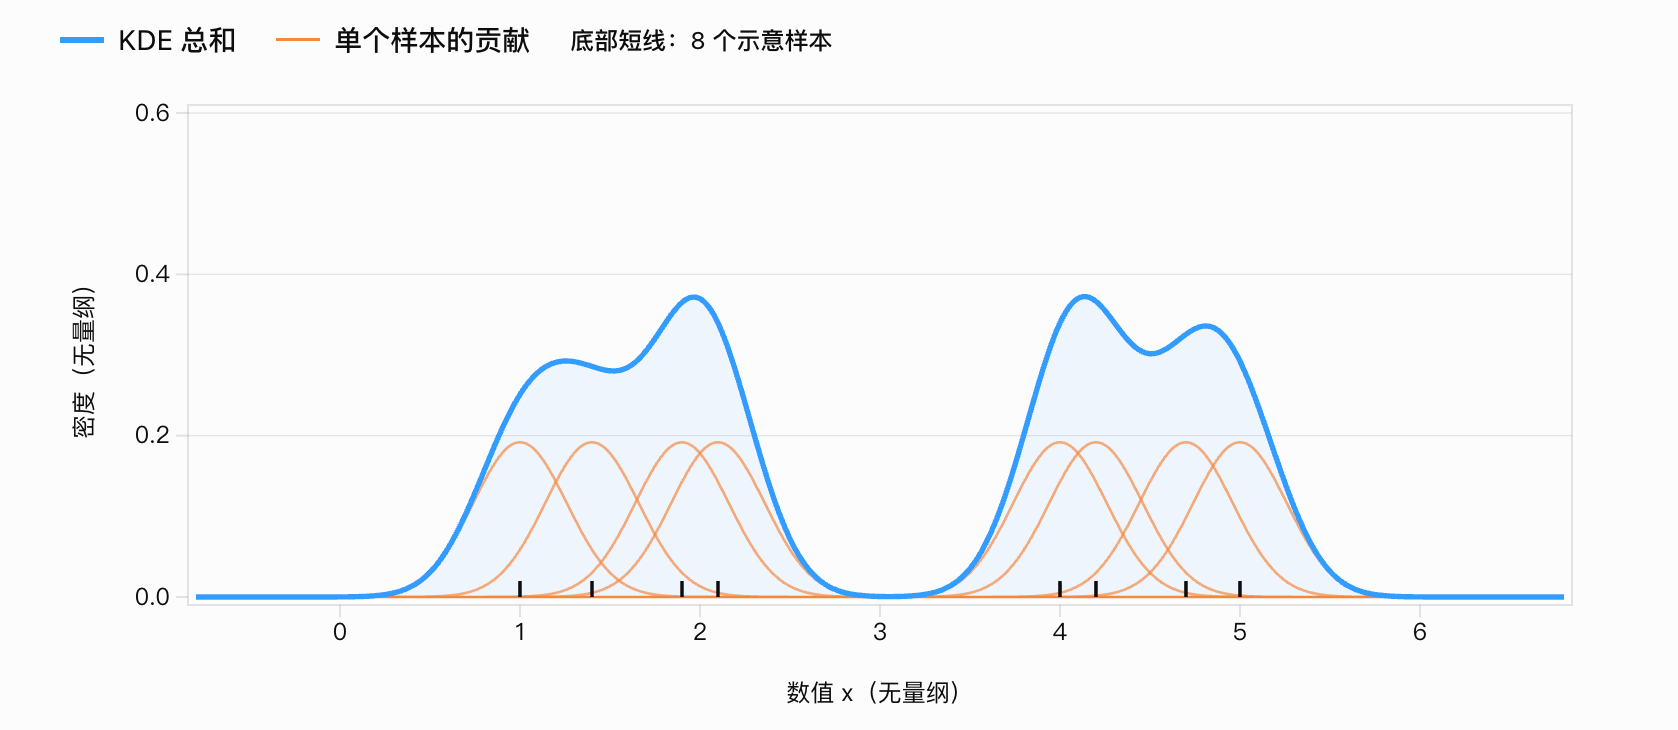
KDE 给每个观测点的帽子,就是这个点对周围所有区域的影响,这个影响的分布是你的核函数的分布
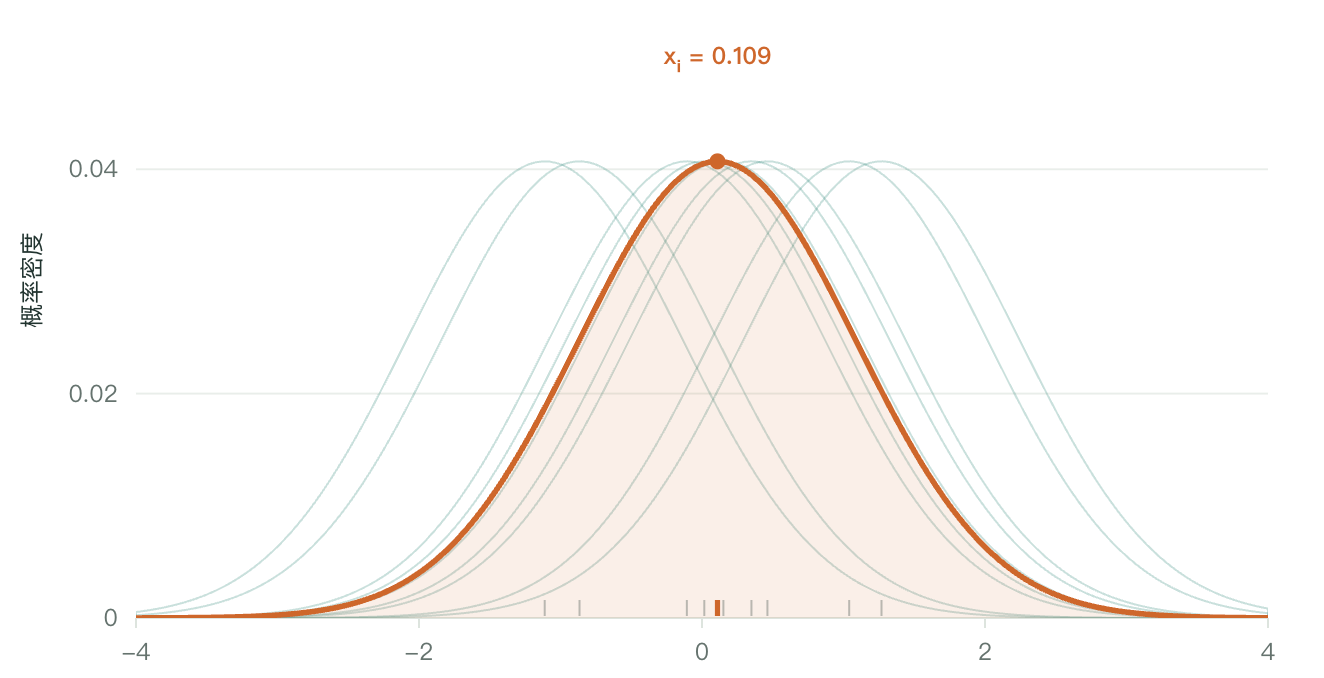
对于一个具体 的概率密度就是所有观测点 对 的影响累积。
这个累加和就是输入 ,所有帽子,对这个点的影响之和。 就是 为均值 为方差的高斯分布。
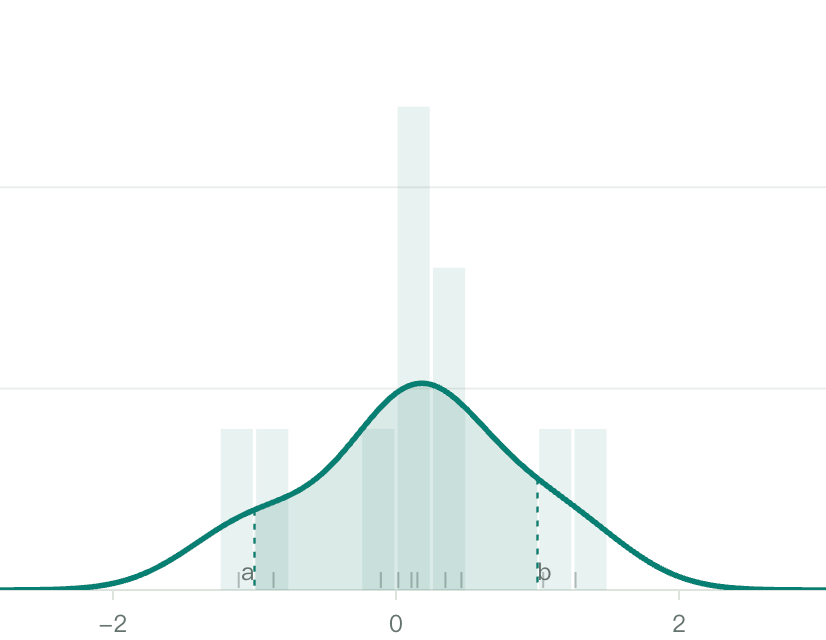
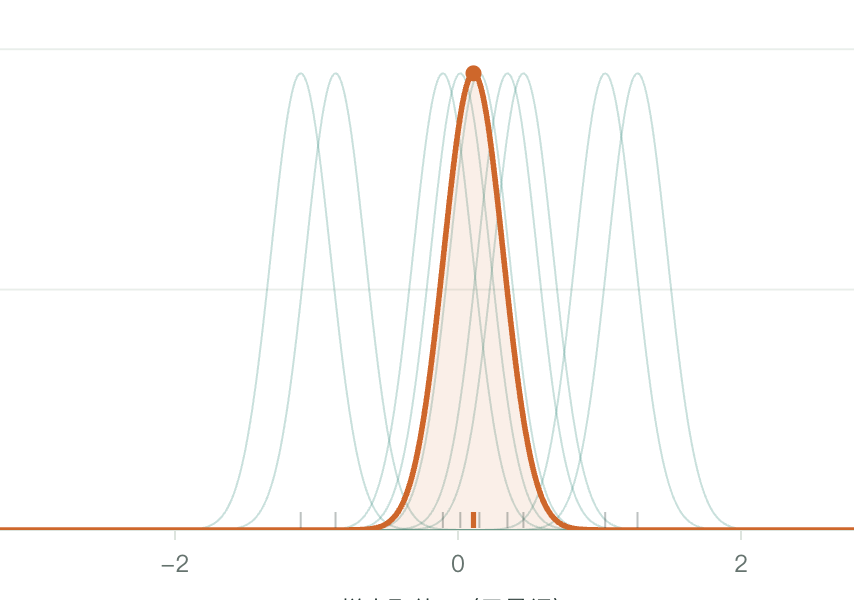
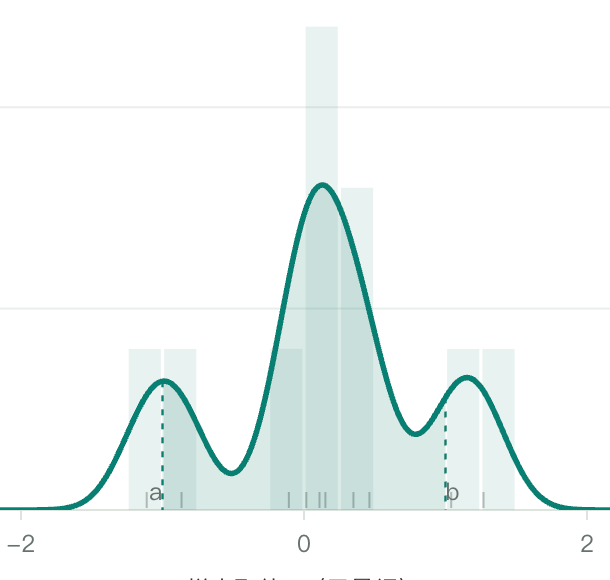
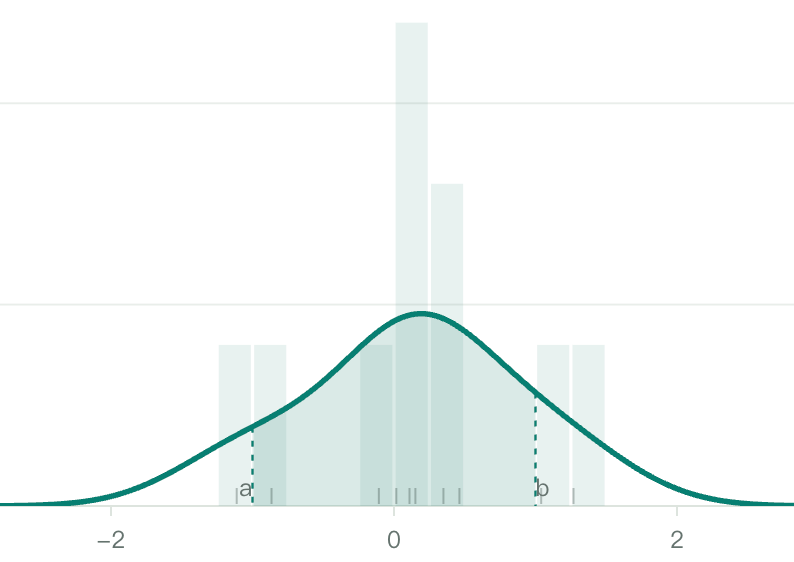
公式中的 也就是这个核函数的高斯分布的方差了,那么 越小,高斯分布越聚集,那么KDE就越尖锐(存在多峰);反之KDE越平缓。
如:
总结
KDE就是一个对离散观测估计其具体概率密度分布的工具。好处是:
- 可以细粒度的刻画分布,可自行调整选择合适的粒度
- 求概率就是求积分,可导可优化,这是一个很重要也很有效的性质
本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来源 EnterSuper!